
Код Хэмминга. Пример работы алгоритма
Вступление.
Прежде всего стоит сказать, что такое Код Хэмминга и для чего он, собственно, нужен. На Википедии
даётся следующее определение:
Коды Хэмминга — наиболее известные и, вероятно, первые из самоконтролирующихся и самокорректирующихся кодов. Построены они применительно к двоичной системе счисления.
Другими словами, это алгоритм, который позволяет закодировать какое-либо информационное сообщение определённым образом и после передачи (например по сети) определить появилась ли какая-то ошибка в этом сообщении (к примеру из-за помех) и, при возможности, восстановить это сообщение. Сегодня, я опишу самый простой алгоритм Хемминга, который может исправлять лишь одну ошибку.
Также стоит отметить, что существуют более совершенные модификации данного алгоритма, которые позволяют обнаруживать (и если возможно исправлять) большее количество ошибок.
Сразу стоит сказать, что Код Хэмминга состоит из двух частей. Первая часть кодирует исходное сообщение, вставляя в него в определённых местах контрольные биты (вычисленные особым образом). Вторая часть получает входящее сообщение и заново вычисляет контрольные биты (по тому же алгоритму, что и первая часть). Если все вновь вычисленные контрольные биты совпадают с полученными, то сообщение получено без ошибок. В противном случае, выводится сообщение об ошибке и при возможности ошибка исправляется.
Как это работает.
Для того, чтобы понять работу данного алгоритма, рассмотрим пример.
Подготовка
Допустим, у нас есть сообщение «habr», которое необходимо передать без ошибок. Для этого сначала нужно наше сообщение закодировать при помощи Кода Хэмминга. Нам необходимо представить его в бинарном виде.
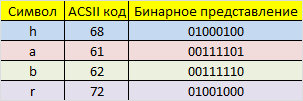
На этом этапе стоит определиться с, так называемой, длиной информационного слова, то есть длиной строки из нулей и единиц, которые мы будем кодировать. Допустим, у нас длина слова будет равна 16. Таким образом, нам необходимо разделить наше исходное сообщение («habr») на блоки по 16 бит, которые мы будем потом кодировать отдельно друг от друга. Так как один символ занимает в памяти 8 бит, то в одно кодируемое слово помещается ровно два ASCII символа. Итак, мы получили две бинарные строки по 16 бит:
После этого процесс кодирования распараллеливается, и две части сообщения («ha» и «br») кодируются независимо друг от друга. Рассмотрим, как это делается на примере первой части.
Прежде всего, необходимо вставить контрольные биты. Они вставляются в строго определённых местах — это позиции с номерами, равными степеням двойки. В нашем случае (при длине информационного слова в 16 бит) это будут позиции 1, 2, 4, 8, 16. Соответственно, у нас получилось 5 контрольных бит (выделены красным цветом):
Таким образом, длина всего сообщения увеличилась на 5 бит. До вычисления самих контрольных бит, мы присвоили им значение «0».
Вычисление контрольных бит.
Теперь необходимо вычислить значение каждого контрольного бита. Значение каждого контрольного бита зависит от значений информационных бит (как неожиданно), но не от всех, а только от тех, которые этот контрольных бит контролирует. Для того, чтобы понять, за какие биты отвечает каждых контрольный бит необходимо понять очень простую закономерность: контрольный бит с номером N контролирует все последующие N бит через каждые N бит, начиная с позиции N. Не очень понятно, но по картинке, думаю, станет яснее:
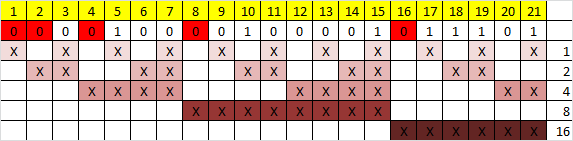
Здесь знаком «X» обозначены те биты, которые контролирует контрольный бит, номер которого справа. То есть, к примеру, бит номер 12 контролируется битами с номерами 4 и 8. Ясно, что чтобы узнать какими битами контролируется бит с номером N надо просто разложить N по степеням двойки.
Но как же вычислить значение каждого контрольного бита? Делается это очень просто: берём каждый контрольный бит и смотрим сколько среди контролируемых им битов единиц, получаем некоторое целое число и, если оно чётное, то ставим ноль, в противном случае ставим единицу. Вот и всё! Можно конечно и наоборот, если число чётное, то ставим единицу, в противном случае, ставим 0. Главное, чтобы в «кодирующей» и «декодирующей» частях алгоритм был одинаков. ( Мы будем применять первый вариант).
Высчитав контрольные биты для нашего информационного слова получаем следующее:
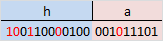
и для второй части:
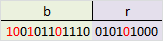
Вот и всё! Первая часть алгоритма завершена.
Декодирование и исправление ошибок.
Теперь, допустим, мы получили закодированное первой частью алгоритма сообщение, но оно пришло к нас с ошибкой. К примеру мы получили такое (11-ый бит передался неправильно):
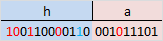
Вся вторая часть алгоритма заключается в том, что необходимо заново вычислить все контрольные биты (так же как и в первой части) и сравнить их с контрольными битами, которые мы получили. Так, посчитав контрольные биты с неправильным 11-ым битом мы получим такую картину:
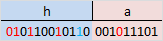
Как мы видим, контрольные биты под номерами: 1, 2, 8 не совпадают с такими же контрольными битами, которые мы получили. Теперь просто сложив номера позиций неправильных контрольных бит (1 + 2 + 8 = 11) мы получаем позицию ошибочного бита. Теперь просто инвертировав его и отбросив контрольные биты, мы получим исходное сообщение в первозданном виде! Абсолютно аналогично поступаем со второй частью сообщения.
Заключение.
В данном примере, я взял длину информационного сообщения именно 16 бит, так как мне кажется, что она наиболее оптимальная для рассмотрения примера (не слишком длинная и не слишком короткая), но конечно же длину можно взять любую. Только стоит учитывать, что в данной простой версии алгоритма на одно информационное слово можно исправить только одну ошибку.
Примечание.
На написание этого топика меня подвигло то, что в поиске я не нашёл на Хабре статей на эту тему (чему я был крайне удивлён). Поэтому я решил отчасти исправить эту ситуацию и максимально подробно показать как этот алгоритм работает. Я намеренно не приводил ни одной формулы, дабы попытаться своими словами донести процесс работы алгоритма на примере.
Источники.
1. Википедия
2. Calculating the Hamming Code
Пример
. Предположим, в канале связи под действием
помех произошло искажение и вместо
0100101 было принято 01001
1
.
Решение
:
Для обнаружения ошибки производят уже
знакомые нам проверки на четность.
Первая
проверка
:
сумма П1+П3+П5+П7
= 0+0+1+1
четна.
В младший разряд номера ошибочной
позиции запишем 0.
Вторая
проверка
:
сумма П2+П3+П6+П7
= 1+0+1+1
нечетна.
Во второй разряд номера ошибочной
позиции запишем 1
Третья
проверка
:
сумма П4+П5+П6+П7
= 0+1+1+1
нечетна.
В третий разряд номера ошибочной позиции
запишем 1. Номер ошибочной позиции 110=
6
. Следовательно,
символ шестой позиции следует изменить
на обратный, и получим правильную кодовую
комбинацию.
Код, исправляющий
одиночную и обнаруживающий двойную
ошибки
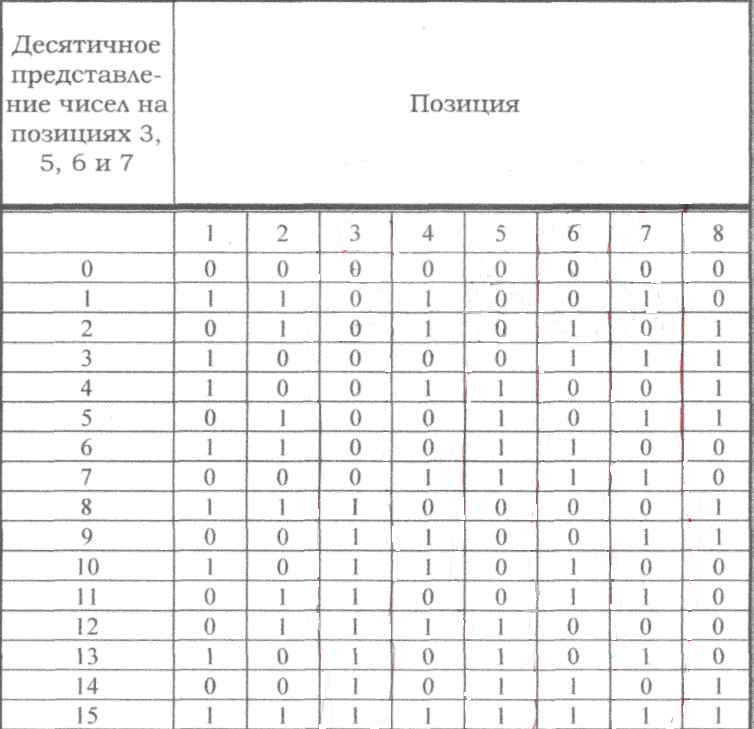
Если по изложенным
выше правилам строить корректирующий
код с обнаружением и исправлением
одиночной ошибки для равномерного
двоичного кода, то первые 16 кодовых
комбинаций будут иметь вид, показанный
в таблице. Такой код может быть использован
для построения кода с исправлением
одиночной ошибки и обнаружением двойной.
Для
этого, кроме указанных выше проверок
по контрольным позициям, следует провести
еще одну проверку на четность для всей
строки в целом. Чтобы осуществить такую
проверку, следует к каждой строке кода
добавить контрольные символы, записанные
в дополнительной колонке (таблица,
колонка 8). Тогда в случае одной ошибки
проверки по позициям укажут номер
ошибочной позиции, а проверка на четность
— на наличие ошибки. Если проверки позиций
укажут на наличие ошибки, а проверка на
четность не фиксирует ее, значит в
кодовой комбинации две ошибки.
1 Двоичные циклические коды
Вышеприведенная
процедура построения линейного кода
матричным методом имеет ряд недостатков.
Она неоднозначна (МДР можно задать
различным образом) и неудобна
в реализации в виде технических устройств.
Этих недостатков лишены
линейные корректирующие коды, принадлежащие
к классу цикли
ческих
.
Циклическими
называют
линейные (
n
,
k
)-коды,
обладающие
следующим свойством:
для любого кодового слова:
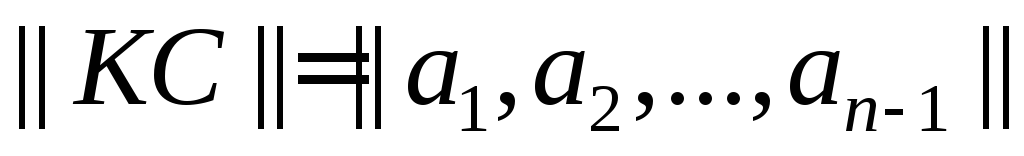
существует другое
кодовое слово:
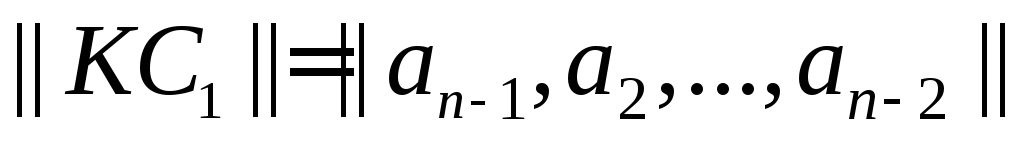
Для
описания циклических кодов используют
полиномы с фиктивной
переменной
X
.
Его
можно описать полиномом
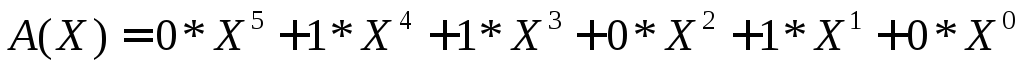
Таким
образом, разряды кодового слова в
описывающем его полиноме используются
в качестве коэффициентов при степенях
фиктивной переменной
X
.
Наибольшая
степень фиктивной переменной X
в
слагаемом с ненулевым
коэффициентом называется степенью
полинома. В вышеприведенном примере
получился полином 4-й степени.
Теперь
действия над кодовыми словами сводятся
к действиям над полиномами.
Вместо алгебры матриц здесь используется
алгебра полиномов.
Рассмотрим
алгебраические действия над полиномами,
используемые в теории
циклических кодов. Суммирование
полиномов разберем на примере
С(Х)
=
А(Х)+В(Х).
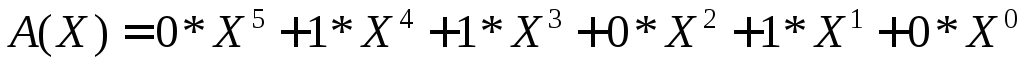
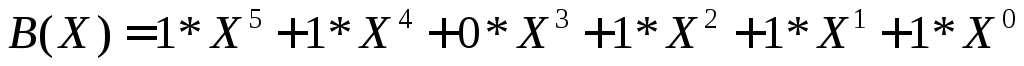
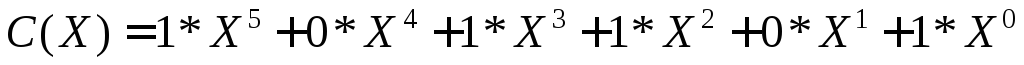
Таким
образом, при суммировании коэффициентов
при X
в одинаковой степени
результат берется по модулю 2. При таком
правиле вычитание эквивалентно
суммированию.
Умножение
выполняется как обычно, но с использованием
суммирования
по модулю 2
.
Рассмотрим
умножение на примере умножения полинома
(
X
3
+
X
1
+
X
0
)
Операция
— обратная умножению -деление. Деление
полиномов выполняется как обычно, за
исключением того, что вычитание
выполняется по модулю 2. Вспомним, что
вычитание по модулю 2 эквивалентно
сложению по модулю 2
Пример
деления полинома X
6
+
X
4
+
X
3
на полином
X
3
+
X
2
+1
Циклический
сдвиг влево на одну позицию коэффициентов
полинома степени n
-1
получается
путем его умножения на X
с
последующим вычитанием из
результата полинома X
n
+1
,
если его порядок >
п.
Проверим это на
примере.
Пусть требуется
выполнить циклический сдвиг влево на
одну позицию
В результате должен
получиться полином
В
основе циклического кода лежит образующий
полином r
-го
порядка
(напомним, что r
—
число дополнительных разрядов). Будем
обозначать
его g
r
(
X
).
Образование
кодовых слов (кодирование) КС
выполняется
путем умножения
информационного полинома с коэффициентами,
являющимися информационной
последовательностью
И(Х)
порядка
i
<
k
на
образующий полином g
r
(
X
)
Принятое кодовое
слово может отличаться от переданного
искаженными разрядами в результате
воздействия помех.
где
ВО(Х)
—
полином
вектора ошибки, а суммирование, как
обычно, ведется
по модулю 2
.
Декодирование,
как и раньше начинается с нахождения
опознавателя,
в данном случае в виде полинома ОП(Х).
Этот
полином вычисляется как
остаток от деления полинома принятого
кодового слова ПКС(Х)
на
образующий
полином g
(
Х):
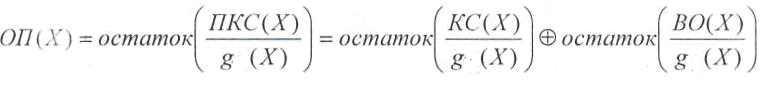
Первое
слагаемое остатка не имеет, т.к. кодовое
слово было образовано путем умножения
полинома информационной последовательности
на
образующий полином. Следовательно, и в
данном случае опознаватель
полностью зависит от вектора ошибки.
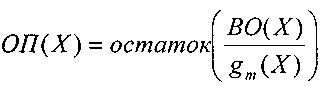
Образующий
полином выбирается таким, чтобы при
данном r
как
можно
большее число отношений ВО(Х)/
g
(Х)
давало
различные остатки.
Такому
требованию отвечают так называемые
неприводимые
поли
номы,
которые
не делятся без остатка ни на один полином
степени r
и ниже, а
делятся только сами на себя и на 1.
Приведенная
здесь процедура образования кодового
слова неудобна тем,
что такой код получается несистематическим,
т.е. таким, в кодовых словах
которого нельзя выделить информационные
и дополнительные разряды.
Этот недостаток
был устранен следующим образом.
Способ
кодирования, приводящий к получению
систематического линейного циклического
кода, состоит в приписывании к
информационной
последовательности И
дополнительных разрядов ДР.
Эти
дополнительные разряды предлагается
находить по следующей формуле:
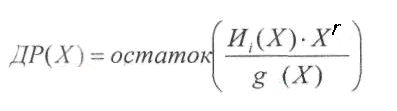
Порядок
полинома ДР(Х)
гарантировано
меньше r
(поскольку
это остаток).
Приписывание
дополнительных разрядов к информационной
последовательности,
используя алгебру полиномов, можно
описать формулой:

Одним
из свойств циклических линейных кодов
является то, что результат
деления любого разрешенного кодового
слова КС
на
образующий полином также, является
разрешенным кодовым словом.
Покажем,
что получаемые по вышеприведенному
алгоритму кодовые
слова являются кодовыми словами
циклического линейного кода. Для
этого нужно убедиться в том, что
произвольное разрешенное кодовое
слово делится на образующий полином
g
(
X
)
без остатка:
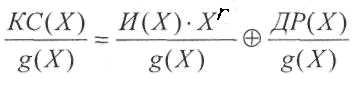
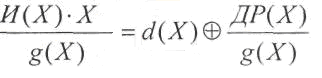
где
d
(Х)
—
целая
часть результата деления.
Подставим полученную
сумму на место первого слагаемого:

Суммирование
последних двух слагаемых дает нулевой
результат (напомним,
что суммирование выполняется по модулю
2).

—
целая часть деления. Остатка нет. Это
означает,
что описанный выше способ кодирования
соответствует циклическому
коду.
Due to the limited redundancy that Hamming codes add to the data, they can only detect and correct errors when the error rate is low. Так обстоит дело с памятью компьютера (обычно ОЗУ), где битовые ошибки встречаются крайне редко и широко используются коды Хэмминга, а ОЗУ с такой системой коррекции представляет собой ОЗУ ECC (ECC-память). В этом контексте часто используется расширенный код Хэмминга, имеющий один дополнительный бит четности. Расширенные коды Хэмминга достигают расстояния Хэмминга, равного четырем, что позволяет декодеру различать, когда возникает не более одной однобитовой ошибки, и когда возникают любые двухбитные ошибки. В этом смысле расширенные коды Хэмминга исправляют одиночные ошибки и обнаруживают двойные ошибки, сокращенно SECDED .
.
Ричард Хэмминг, изобретатель кодов Хэмминга, работал в Bell Labs в конце 1940-х годов над компьютером Bell Model V, электромеханической релейной машиной с временем цикла в секундах. Входные данные подавались на перфоленту шириной семь восьмых дюйма, на которой было до шести отверстий в ряду. В будние дни, когда обнаруживались ошибки в реле, машина останавливалась и мигала светом, чтобы операторы могли устранить проблему. В нерабочее время и в выходные дни, когда операторов не было, машина просто переходила к следующему заданию.
Коды до Хэмминга
До кодов Хэмминга использовался ряд простых кодов обнаружения ошибок, но ни один из них не был столь же эффективен, как коды Хэмминга при тех же затратах пространства.
Четность добавляет один бит, который указывает, было ли количество единиц (битовых позиций со значениями единица) в предыдущих данных четным или нечетным. Если при передаче изменяется нечетное количество битов, сообщение меняет четность, и на этом этапе можно обнаружить ошибку; однако бит, который изменился, мог быть самим битом четности. Наиболее распространенное соглашение заключается в том, что значение четности, равное единице, указывает на нечетное количество единиц в данных, а значение четности, равное нулю, указывает на наличие четного числа единиц. Если количество измененных битов четное, проверочный бит будет действительным и ошибка не будет обнаружена.
Более того, четность не указывает, какой бит содержит ошибку, даже если она может ее обнаружить. Данные должны быть полностью удалены и повторно переданы с нуля. В зашумленной среде передачи успешная передача может занять много времени или вообще не произойти. Однако, хотя качество проверки четности оставляет желать лучшего, поскольку используется только один бит, этот метод обеспечивает наименьшие издержки.
Код «два из пяти» — это схема кодирования, в которой используются пять битов, состоящих ровно из трех нулей и двух единиц. Это обеспечивает десять возможных комбинаций, достаточных для представления цифр 0–9. Эта схема может обнаруживать все одиночные битовые ошибки, все битовые ошибки с нечетными номерами и некоторые битовые ошибки с четными номерами (например, переворот обоих 1-битов). Однако он по-прежнему не может исправить ни одну из этих ошибок.
Другой код, использовавшийся в то время, повторял каждый бит данных несколько раз, чтобы убедиться, что он был отправлен правильно. Например, если отправляемый бит данных равен 1, код повторения
отправит 111. Если три полученных бита не идентичны, во время передачи произошла ошибка. Если канал достаточно чист, в большинстве случаев в каждой тройке будет меняться только один бит. Таким образом, 001, 010 и 100 соответствуют 0 битам, а 110, 101 и 011 соответствуют 1 биту, причем большее количество одинаковых цифр («0» или «1») указывает, что именно. бит данных должен быть. Код, обладающий способностью восстанавливать исходное сообщение при наличии ошибок, известен как исправляющий ошибки .
код. Этот код тройного повторения представляет собой код Хэмминга с m
= 2,
поскольку имеется два бита четности, и 2 2
− 2 − 1 = 1
бит данных.
Однако такие коды не могут правильно исправить все ошибки. В нашем примере, если канал меняет местами два бита и получатель получает 001, система обнаружит ошибку, но придет к выводу, что исходный бит равен 0, что неверно. Если мы увеличим размер битовой строки до четырех, мы сможем обнаружить все двухбитовые ошибки, но не сможем их исправить (количество битов четности будет четным); при пяти битах мы можем обнаружить и исправить все двухбитные ошибки, но не все трехбитные ошибки.
Более того, увеличение размера строки битов четности неэффективно, поскольку в нашем исходном случае пропускная способность снижается в три раза, а эффективность резко падает, когда мы увеличиваем количество дублирований каждого бита, чтобы обнаружить и исправить больше ошибки.
Если в сообщение включено больше битов, исправляющих ошибки, и если эти биты можно расположить так, что разные неверные биты дают разные результаты ошибки, тогда можно идентифицировать плохие биты. В семибитном сообщении существует семь возможных однобитовых ошибок, поэтому три бита контроля ошибок потенциально могут указывать не только на то, что произошла ошибка, но и на то, какой бит ее вызвал.
Хэмминг также заметил проблемы с инвертированием двух или более битов и описал это как «расстояние» (теперь оно называется расстоянием Хэмминга
, после него). Расстояние четности равно 2, поэтому один битовый переворот может быть обнаружен, но не исправлен, и любые два переворота бита будут невидимы. Повторение (3,1) имеет расстояние 3, так как три бита необходимо перевернуть в одной тройке, чтобы получить другое кодовое слово без видимых ошибок. Он может исправлять однобитные ошибки или обнаруживать (но не исправлять) двухбитные ошибки. Повторение (4,1) (каждый бит повторяется четыре раза) имеет расстояние 4, поэтому переворот трех битов можно обнаружить, но не исправить. Когда три бита в одной группе меняются, могут возникнуть ситуации, когда попытка исправления приведет к неправильному кодовому слову. В общем, код с расстоянием k
может обнаружить, но не исправить ошибки.
Хэмминга интересовали сразу две задачи: максимально увеличить расстояние и в то же время максимально увеличить скорость кода. В 1940-х годах он разработал несколько схем кодирования, которые значительно усовершенствовали существующие коды. Ключом ко всем его системам было перекрытие битов четности, чтобы им удавалось проверять друг друга, а также данные.
- Пронумеруйте биты, начиная с 1: бит 1, 2, 3, 4, 5, 6, 7 и т. д.
- Запишите номера битов в двоичном формате: 1, 10, 11, 100, 101, 110, 111 и т. д.
- Все позиции битов, которые являются степенями двойки (имеют один бит 1 в двоичной форме своей позиции), являются битами четности: 1, 2, 4, 8 и т. д. (1, 10, 100, 1000)
- Все остальные позиции битов с двумя или более битами 1 в двоичной форме их позиции являются битами данных.
- Каждый бит данных включен в уникальный набор из 2 или более битов четности, что определяется двоичной формой его битовой позиции.
- Бит четности 1 охватывает все позиции битов, которые имеют наименьшее значение.
набор значащих битов: бит 1 (сам бит четности), 3, 5, 7, 9 и т. д. - Бит четности 2 охватывает все позиции битов, которые имеют вторую
набор младших битов: биты 2–3, 6–7, 10–11 и т. д. - Бит четности 4 охватывает все позиции битов, которые имеют третью
набор младших битов: биты 4–7, 12–15, 20–23 и т. д. - Бит четности 8 охватывает все позиции битов, которые имеют четвертую
набор младших битов: биты 8–15, 24–31, 40–47 и т. д. - В общем, каждый бит четности охватывает все биты, где побитовое И позиции четности и позиции бита не равно нулю.
- Бит четности 1 охватывает все позиции битов, которые имеют наименьшее значение.
Если кодируемый байт данных равен 10011010, то слово данных (с использованием _ для представления битов четности) будет __1_001_1010, а кодовое слово — 011100101010.
Выбор четности, четной или нечетной, не имеет значения, но один и тот же выбор должен использоваться как для кодирования, так и для декодирования.
Это общее правило можно показать наглядно:
Показаны только 20 закодированных битов (5 четности, 15 данных), но шаблон продолжается бесконечно. Ключевая особенность кодов Хэмминга, которую можно увидеть при визуальном осмотре, заключается в том, что любой данный бит включен в уникальный набор битов четности. Чтобы проверить наличие ошибок, проверьте все биты четности. Структура ошибок, называемая синдромом ошибки, идентифицирует ошибочный бит. Если все биты четности верны, ошибки нет. В противном случае сумма позиций ошибочных битов четности идентифицирует ошибочный бит. Например, если биты четности в позициях 1, 2 и 8 указывают на ошибку, то бит 1+2+8=11 является ошибкой. Если только один бит четности указывает на ошибку, то сам бит четности ошибочен.
С битами четности, биты от 1 до
можно покрыть. После дисконтирования битов четности
биты остаются для использования в качестве данных. В зависимости от изменений мы получаем все возможные коды Хэмминга:
Коды Хэмминга с дополнительной четностью (SECDED)
Коды Хэмминга имеют минимальное расстояние 3, что означает, что декодер может обнаружить и исправить одиночную ошибку, но он не может отличить двойную битовую ошибку некоторого кодового слова от одинарной битовой ошибки другого кодового слова. Таким образом, некоторые двухбитовые ошибки будут неправильно декодированы, как если бы они были однобитовыми ошибками, и, следовательно, останутся незамеченными, если не будет предпринята попытка исправления.
Чтобы исправить этот недостаток, коды Хэмминга можно расширить дополнительным битом четности. Таким образом можно увеличить минимальное расстояние кода Хэмминга до 4, что позволяет декодеру различать однобитовые и двухбитовые ошибки. Таким образом, декодер может обнаружить и исправить одиночную ошибку и в то же время обнаружить (но не исправить) двойную ошибку.
Если декодер не пытается исправить ошибки, он может надежно обнаружить тройные битовые ошибки. Если декодер исправляет ошибки, некоторые тройные ошибки будут приняты за одиночные и «исправлены» до неправильного значения. Таким образом, исправление ошибок — это компромисс между уверенностью (способностью надежно обнаруживать тройные битовые ошибки) и устойчивостью (способностью продолжать работу даже при однобитовых ошибках).

Графическое изображение четырех битов данных и трех битов четности и того, какие биты четности к каким битам данных относятся
Построение G и H
Матрица
называется (канонической) порождающей матрицей линейного ( n
, к
) код,

и
называется проверочной матрицей.

Таким образом H
– это матрица, левая часть которой состоит из ненулевых n
-кортежи, где порядок n
-кортежи в столбцах матрицы не имеют значения. Правая часть — это просто ( n
− к
)-единичная матрица.
Итак
Г
можно получить из H
транспонировав левую часть H
с тождеством к
-идентичная матрица в левой части G
.
Матрица генератора кода
и матрица проверки четности
являются:


- Перестановки столбцов (замена столбцов)
- Элементарные операции со строками (замена строки линейной комбинацией строк)
- Пример
Из приведенной выше матрицы имеем 2 k
= 2 4
= 16 кодовых слов.
Пусть
быть вектором-строкой битов двоичных данных,
. Кодовое слово
для любого из 16 возможных векторов данных
дается стандартным матричным произведением
где операция суммирования выполняется по модулю-2.


Например, пусть
. Использование матрицы-генератора
сверху имеем (после применения к сумме по модулю 2):


Обратите внимание, что H не имеет стандартной формы. Чтобы получить G, можно использовать элементарные операции со строками для получения эквивалентной матрицы H в систематической форме:
Например, первая строка в этой матрице представляет собой сумму второй и третьей строк H в несистематической форме. Используя приведенную выше систематическую конструкцию для кодов Хэмминга, матрица A становится очевидной, а систематическая форма G записывается как Несистематическая форма G может быть сокращена по строкам (с использованием элементарных операций над строками), чтобы соответствовать этой матрице. Добавление четвертой строки эффективно вычисляет сумму всех битов кодового слова (данных и четности) как четвертый бит четности. Код Голея Код Рида – Мюллера Исправление ошибок Рида – Соломона

Связанный Хэмминг
Расстояние Хэмминга
- Хэмминг (1950), стр. 153–154.
- ^ а
б
в
Кайт и Кит 2017, с. 115. - Кайт и Кит 2017, с. 95.
- Мун Т. Кодирование с коррекцией ошибок: математические методы и
Алгоритмы. Джон Уайли и сыновья, 2005. (Глава 3) ISBN 978-0-471-64800-0
Томпсон, Томас М. (1983), От кодов, исправляющих ошибки, через сферические упаковки к простым группам
, Математические монографии Каруса (№ 21), Математическая ассоциация Америки, стр. 16–17, ISBN 0-88385-023-0
- Хэмминг, Ричард Уэсли (1950). «Коды обнаружения и исправления ошибок». Технический журнал Bell System
. 29 - Мун, Тодд К. (2005). Кодирование с коррекцией ошибок
. Нью-Джерси: Джон Уайли и сыновья. И СБН 978-0-471-64800-0.
- Маккей, Дэвид Дж. К. (сентябрь 2003 г.). Теория информации, логический вывод и алгоритмы обучения
. Кембридж: Издательство Кембриджского университета. И СБН 0-521-64298-1.
- Д. К. Бхаттачаррия, С. Нанди. «Эффективный класс кодов SEC-DED-AUED». Международный симпозиум 1997 г. по параллельным архитектурам, алгоритмам и сетям (ISPAN ’97)
. стр. 410–415. doi:10.1109/ИСПАН.1997.645128.
- «Математическая задача апрель 2013 Коды, исправляющие ошибки». Руководитель группы SwissQuant. Апрель 2013 г. Архивировано из оригинала 12 сентября 2017 г.
- Кайт, Дэйв К.; Кит, Прем К. (28 июля 2017 г.). «Расширенные коды Хэмминга». Алгебраическая и стохастическая теория кодирования
. C RC Пресс. стр. 95–116. И СБН 978-1-351-83245-8.
: 147–160. doi:10.1002/j.1538-7305.1950.tb00463.x. S2CID 61141773. Архивировано из оригинала 9 октября 2022 г.
- Визуальное объяснение кодов Хэмминга
- CGI-скрипт для расчета расстояний Хэмминга (от Р. Терво, UNB, Канада)
- Инструмент для расчета кода Хэмминга
Из-за ограниченной избыточности, которую коды Хэмминга добавляют к данным, они могут обнаруживать и исправлять ошибки только при низкой частоте ошибок. Так обстоит дело с памятью компьютера (обычно ОЗУ), где битовые ошибки встречаются крайне редко и широко используются коды Хэмминга, а ОЗУ с такой системой коррекции представляет собой ОЗУ ECC (ECC-память). В этом контексте часто используется расширенный код Хэмминга, имеющий один дополнительный бит четности. Расширенные коды Хэмминга достигают расстояния Хэмминга, равного четырем, что позволяет декодеру различать, когда возникает не более одной однобитовой ошибки, и когда возникают любые двухбитные ошибки. В этом смысле расширенные коды Хэмминга исправляют одиночные ошибки и обнаруживают двойные ошибки, сокращенно SECDED .
.
Ричард Хэмминг, изобретатель кодов Хэмминга, работал в Bell Labs в конце 1940-х годов над компьютером Bell Model V, электромеханической релейной машиной с временем цикла в секундах. Входные данные подавались на перфоленту шириной семь восьмых дюйма, на которой было до шести отверстий в ряду. В будние дни, когда обнаруживались ошибки в реле, машина останавливалась и мигала светом, чтобы операторы могли устранить проблему. В нерабочее время и в выходные дни, когда операторов не было, машина просто переходила к следующему заданию.
Коды до Хэмминга
До кодов Хэмминга использовался ряд простых кодов обнаружения ошибок, но ни один из них не был столь же эффективен, как коды Хэмминга при тех же затратах пространства.
Четность добавляет один бит, который указывает, было ли количество единиц (битовых позиций со значениями единица) в предыдущих данных четным или нечетным. Если при передаче изменяется нечетное количество битов, сообщение меняет четность, и на этом этапе можно обнаружить ошибку; однако бит, который изменился, мог быть самим битом четности. Наиболее распространенное соглашение заключается в том, что значение четности, равное единице, указывает на нечетное количество единиц в данных, а значение четности, равное нулю, указывает на наличие четного числа единиц. Если количество измененных битов четное, проверочный бит будет действительным и ошибка не будет обнаружена.
Более того, четность не указывает, какой бит содержит ошибку, даже если она может ее обнаружить. Данные должны быть полностью удалены и повторно переданы с нуля. В зашумленной среде передачи успешная передача может занять много времени или вообще не произойти. Однако, хотя качество проверки четности оставляет желать лучшего, поскольку используется только один бит, этот метод обеспечивает наименьшие издержки.
Код «два из пяти» — это схема кодирования, в которой используются пять битов, состоящих ровно из трех нулей и двух единиц. Это обеспечивает десять возможных комбинаций, достаточных для представления цифр 0–9. Эта схема может обнаруживать все одиночные битовые ошибки, все битовые ошибки с нечетными номерами и некоторые битовые ошибки с четными номерами (например, переворот обоих 1-битов). Однако он по-прежнему не может исправить ни одну из этих ошибок.
Другой код, использовавшийся в то время, повторял каждый бит данных несколько раз, чтобы гарантировать, что он был отправлен правильно. Например, если отправляемый бит данных равен 1, код повторения
отправит 111. Если три полученных бита не идентичны, во время передачи произошла ошибка. Если канал достаточно чист, в большинстве случаев в каждой тройке будет меняться только один бит. Таким образом, 001, 010 и 100 соответствуют 0 битам, а 110, 101 и 011 соответствуют 1 биту, причем большее количество одинаковых цифр («0» или «1») указывает, что именно. бит данных должен быть. Код, обладающий способностью восстанавливать исходное сообщение при наличии ошибок, известен как исправляющий ошибки .
код. Этот код тройного повторения представляет собой код Хэмминга с m
= 2,
поскольку имеется два бита четности, и 2 2
− 2 − 1 = 1
бит данных.
Однако такие коды не могут правильно исправить все ошибки. В нашем примере, если канал меняет местами два бита и получатель получает 001, система обнаружит ошибку, но придет к выводу, что исходный бит равен 0, что неверно. Если мы увеличим размер битовой строки до четырех, мы сможем обнаружить все двухбитовые ошибки, но не сможем их исправить (количество битов четности будет четным); при пяти битах мы можем обнаружить и исправить все двухбитные ошибки, но не все трехбитные ошибки.
Более того, увеличение размера строки битов четности неэффективно, поскольку в нашем исходном случае пропускная способность снижается в три раза, а эффективность резко падает, когда мы увеличиваем количество дублирований каждого бита, чтобы обнаружить и исправить больше ошибки.
Если в сообщение включено больше битов, исправляющих ошибки, и если эти биты можно расположить так, что разные неправильные биты дают разные результаты ошибки, тогда можно идентифицировать плохие биты. В семибитном сообщении существует семь возможных однобитовых ошибок, поэтому три бита контроля ошибок потенциально могут указывать не только на то, что произошла ошибка, но и на то, какой бит ее вызвал.
Хэмминг также заметил проблемы с инвертированием двух или более битов и описал это как «расстояние» (теперь оно называется Расстоянием Хэмминга
, после него). Расстояние четности равно 2, поэтому один битовый переворот может быть обнаружен, но не исправлен, и любые два переворота бита будут невидимы. Повторение (3,1) имеет расстояние 3, так как три бита необходимо перевернуть в одной тройке, чтобы получить другое кодовое слово без видимых ошибок. Он может исправлять однобитные ошибки или обнаруживать (но не исправлять) двухбитные ошибки. Повторение (4,1) (каждый бит повторяется четыре раза) имеет расстояние 4, поэтому переворот трех битов можно обнаружить, но не исправить. Когда три бита в одной группе меняются, могут возникнуть ситуации, когда попытка исправления приведет к неправильному кодовому слову. В общем случае код с расстоянием k
может обнаружить, но не исправить ошибки.
Хэмминга интересовали сразу две задачи: максимально увеличить расстояние и в то же время максимально увеличить скорость кода. В 1940-х годах он разработал несколько схем кодирования, которые значительно усовершенствовали существующие коды. Ключом ко всем его системам было перекрытие битов четности, чтобы им удавалось проверять друг друга, а также данные.
- Пронумеруйте биты, начиная с 1: бит 1, 2, 3, 4, 5, 6, 7 и т. д.
- Запишите номера битов в двоичном формате: 1, 10, 11, 100, 101, 110, 111 и т. д.
- Все позиции битов, которые являются степенями двойки (имеют один бит 1 в двоичной форме своей позиции), являются битами четности: 1, 2, 4, 8 и т. д. (1, 10, 100, 1000)
- Все остальные позиции битов с двумя или более битами 1 в двоичной форме их позиции являются битами данных.
- Каждый бит данных включен в уникальный набор из 2 или более битов четности, что определяется двоичной формой его битовой позиции.
- Бит четности 1 охватывает все позиции битов, которые имеют наименьшее значение.
набор значащих битов: бит 1 (сам бит четности), 3, 5, 7, 9 и т. д. - Бит четности 2 охватывает все позиции битов, которые имеют вторую
набор младших битов: биты 2–3, 6–7, 10–11 и т. д. - Бит четности 4 охватывает все позиции битов, которые имеют третью
набор младших битов: биты 4–7, 12–15, 20–23 и т. д. - Бит четности 8 охватывает все позиции битов, которые имеют четвертую
набор младших битов: биты 8–15, 24–31, 40–47 и т. д. - В общем, каждый бит четности охватывает все биты, где побитовое И позиции четности и позиции бита не равно нулю.
- Бит четности 1 охватывает все позиции битов, которые имеют наименьшее значение.
Если кодируемый байт данных равен 10011010, то слово данных (с использованием _ для представления битов четности) будет __1_001_1010, а кодовое слово — 011100101010.
Выбор четности, четной или нечетной, не имеет значения, но один и тот же выбор должен использоваться как для кодирования, так и для декодирования.
Это общее правило можно показать наглядно:
Показаны только 20 закодированных битов (5 четности, 15 данных), но шаблон продолжается бесконечно. Ключевая особенность кодов Хэмминга, которую можно увидеть при визуальном осмотре, заключается в том, что любой данный бит включен в уникальный набор битов четности. Чтобы проверить наличие ошибок, проверьте все биты четности. Структура ошибок, называемая синдромом ошибки, идентифицирует ошибочный бит. Если все биты четности верны, ошибки нет. В противном случае сумма позиций ошибочных битов четности идентифицирует ошибочный бит. Например, если биты четности в позициях 1, 2 и 8 указывают на ошибку, то бит 1+2+8=11 является ошибкой. Если только один бит четности указывает на ошибку, то сам бит четности ошибочен.
С битами четности, биты от 1 до
можно покрыть. После дисконтирования битов четности
биты остаются для использования в качестве данных. В зависимости от изменений мы получаем все возможные коды Хэмминга:
Коды Хэмминга с дополнительной четностью (SECDED)
Коды Хэмминга имеют минимальное расстояние 3, что означает, что декодер может обнаружить и исправить одиночную ошибку, но он не может отличить двойную битовую ошибку некоторого кодового слова от одинарной битовой ошибки другого кодового слова. Таким образом, некоторые двухбитовые ошибки будут неправильно декодированы, как если бы они были однобитовыми ошибками, и, следовательно, останутся незамеченными, если не будет предпринята попытка исправления.
Чтобы исправить этот недостаток, коды Хэмминга можно расширить дополнительным битом четности. Таким образом можно увеличить минимальное расстояние кода Хэмминга до 4, что позволяет декодеру различать однобитовые и двухбитовые ошибки. Таким образом, декодер может обнаружить и исправить одиночную ошибку и в то же время обнаружить (но не исправить) двойную ошибку.
Если декодер не пытается исправить ошибки, он может надежно обнаружить тройные битовые ошибки. Если декодер исправляет ошибки, некоторые тройные ошибки будут приняты за одиночные и «исправлены» до неправильного значения. Таким образом, исправление ошибок — это компромисс между уверенностью (способностью надежно обнаруживать тройные битовые ошибки) и устойчивостью (способностью продолжать работу даже при однобитовых ошибках).
Графическое изображение четырех битов данных и трех битов четности и того, какие биты четности к каким битам данных относятся
Построение G и H
Матрица
называется (канонической) порождающей матрицей линейного ( n
, к
) код,
и
называется проверочной матрицей.
Таким образом Ч
– это матрица, левая часть которой состоит из ненулевых n
-кортежи, где порядок n
-кортежи в столбцах матрицы не имеют значения. Правая часть — это просто ( n
− к
)-единичная матрица.
Итак Г
можно получить из H
транспонировав левую часть H
с тождеством к
-идентичная матрица слева от G
.
Матрица генератора кода
и матрица проверки четности
являются:
- Перестановки столбцов (перестановка столбцов)
- Элементарные операции со строками (замена строки линейной комбинацией строк)
- Пример
Из приведенной выше матрицы имеем 2 k
= 2 4
= 16 кодовых слов.
Пусть
быть вектором-строкой битов двоичных данных,
. Кодовое слово
для любого из 16 возможных векторов данных
дается стандартным матричным произведением
где операция суммирования выполняется по модулю-2.
Например, пусть
. Использование матрицы-генератора
сверху имеем (после применения к сумме по модулю 2):
Обратите внимание, что H не имеет стандартной формы. Чтобы получить G, можно использовать элементарные операции со строками для получения эквивалентной матрицы H в систематической форме:

Например, первая строка этой матрицы представляет собой сумму второй и третьей строк H в несистематической форме. Используя приведенную выше систематическую конструкцию для кодов Хэмминга, матрица A становится очевидной, а систематическая форма G записывается как

Несистематическая форма G может быть сокращена по строкам (с использованием элементарных операций над строками), чтобы соответствовать этой матрице.
Добавление четвертой строки эффективно вычисляет сумму всех битов кодового слова (данных и четности) как четвертый бит четности.
- Теория кодирования
- Код Голея
- Код Рида – Мюллера
- Исправление ошибок Рида – Соломона
- Турбокод
- Код проверки четности низкой плотности
- Связанный Хэмминг
- Расстояние Хэмминга
-
а
-
Кайт и Кит 2017, с. 115.
Кайт и Кит 2017, с. 95.
Мун Т. Кодирование с коррекцией ошибок: математические методы и
Алгоритмы. Джон Уайли и сыновья, 2005. (Глава 3) ISBN 978-0-471-64800-0
См. лемму 12 из
Хэмминг (1950), стр. 153–154.
Томпсон, Томас М. (1983), От кодов, исправляющих ошибки, через сферические упаковки к простым группам
, Математические монографии Каруса (№ 21), Математическая ассоциация Америки, стр. 16–17, ISBN 0-88385-023-0
^
- б
в
Хэмминг, Ричард Уэсли (1950). «Коды обнаружения и исправления ошибок». Технический журнал Bell System
.
29
: 147–160. doi:10.1002/j.1538-7305.1950.tb00463.x. S2CID 61141773. Архивировано из оригинала 9 октября 2022 г.
Мун, Тодд К. (2005).
Кодирование коррекции ошибок
. Нью-Джерси: Джон Уайли и сыновья. И СБН 978-0-471-64800-0.
Кодирование коррекции ошибок
. Нью-Джерси: Джон Уайли и сыновья. И СБН 978-0-471-64800-0.
Маккей, Дэвид Дж.К. (сентябрь 2003 г.). Теория информации, логический вывод и алгоритмы обучения
. Кембридж: Издательство Кембриджского университета. И СБН 0-521-64298-1.
Д.К. Бхаттачаррия, С. Нанди. «Эффективный класс кодов SEC-DED-AUED».
Международный симпозиум 1997 г. по параллельным архитектурам, алгоритмам и сетям (ISPAN ’97)
. стр. 410–415. doi:10.1109/ИСПАНСКИЙ.1997.645128.
. . . . C RC Пресс. стр. 100-1 95–116. И СБН 978-1-351-83245-8
- Визуальное объяснение кодов Хэмминга
- CGI-скрипт для расчета расстояний Хэмминга (от Р. Терво, UNB, Канада)
- Инструмент для расчета кода Хэмминга

Оставшуюся часть снежинок покроют снежинки
«Эксклюзивный аналог Avalanche Review»
(ФГОУ ВО «ОмПУ»)
Доступен для столярных работ, столярных работ, грузов и грузов
Авторские права © 2010 Авторские права © 2005 Калифорнийского университета в Беркли
Подзаголовок: День матери
Подзаголовок: Москва и Оранжевый
Субтитры: Видео остальной части страны
«__» _______________ 20___г.
Приложение 1. Видео заснеженных снежинок я
Страницы Другое Веб-сайт бренда Личный блог
Страницы Другое Веб-сайт бренда Личный блог
Pages Общественная личность Copyright © 2017 Рамадан
Урок 2. Дополнительные снежинки на юге
Страницы Компании СМИ/новостные компании Кино/Телевизионная студия
Страницы Компании СМИ/новостные компании Кино/Телевизионная студия
Ряд снежинок-снежинок 1946 года.
г., а имнно, поссле публикации монографии меррикнскосго К. Там написано «Опыт катания на сноуборде и катании на сноуборде». Если вы хотите быть в состоянии сделать это, вы можете сделать это. . . . Если вы хотите, вы можете получить К. Хотим поделиться ассортиментом продукции, а именно: А. Я. Хинчин, Р. Р. Варшамов и др. на сегодняшний день проблема передачи данных нбой передачи вызваче не только сооѱщения в целом, но и по лную основу информации. Если вы хотите запачкать руки, вы можете запачкать руки ерю и введение информации. По ту сторону рожка мороженого снежинки, об Спасибо за прочтение снежинки снежинки и снежинки тоте технических кодирующих и декоющих устройств. Принципиально коды могут быть использованы как для обнаружения, так и для выявления ошибок. Добро пожаловать в снежинки-снежинки и снежинки, которые преуспевают лишь некоторые из них, в частности корректи рующего кода Хемминга.
Неэксклюзивные настройки:
Снимаем снежинки-снежинки и снежинки из снежинок. . .
1) Снимите со снежинок снежинки;
2) Удалить из снежинки, снежинки и снежинки йчивого кодирования;
3) Ещё одна девочка чуть меньше 100 лет.
: Маленькие снежинки.
: Я не уверен.
Дополнительные снежинки-снежинки, снежинки, в ведения, две главы (стена и снег), снежные и ледяные туры.
Предложение материалов, защищенных авторским правом
По ту сторону границы снега и льда всё ещё есть как звуковые воздействия, так и графике. В этом случае оправиться от снежной бури не удастся. Под помехой понимается любое воздействие, накладывающееся на полезный сигнал изатрудняющее его прием. Ниже приведена классификация помех и их источников.
Рис. 1.Помехи и их источники
Приведем классификацию помехоустойчивых кодов.
1) Обнаруживающие ошибки:
- с проверкой на четность;
- с постоянным весом;
2) Корректирующие коды:
А) С пороговым декодированием;
Б) По макс. правдоподобия;
В) С последовательным декодированием.
Теперь рассмотрим более подробно каждый вид кодирования.
Код с проверкой на четность
Проверка четности – очень простой метод для обнаружения ошибок в передаваемом пакете данных. С помощью данного кода мы не можем восстановить данные, но можем обнаружить только лишь одиночную ошибку.
В каждом пакет данных есть один бит четности, или, так называемый, паритетный бит. Этот бит устанавливается во время записи (или отправки) данных, и затем рассчитывается и сравнивается во время чтения (получения) данных. Он равен сумме по модулю 2 всех бит данных в пакете. То есть число единиц в пакете всегда будет четно. Изменение этого бита (например с 0 на 1) сообщает о возникшей ошибке.
Начальные данные: 1111
Данные после кодирования: 11110 (1 + 1 + 1 + 1 = 0 (mod 2))
Принятые данные: 10110 (изменился второй бит)
Корреляционные коды (код с удвоением
Элементы данного кода заменяются двумя символами, единица «1» преобразуется в 10, а ноль «0» в 01.
Код с постоянным весом.
Одним из простейших блочных неразделимых кодов является код с постоянным весом. Примером такого кода может служить семибитный телеграфный код МТК–3, в котором каждая разрешенная кодовая комбинация содержит три единицы и четыре нуля (рис.2). Весом кодовой комбинации называют число содержащихся в ней единиц. В рассматриваемом коде вес кодовых комбинаций равен трем.
Число разрешенных кодовых комбинаций в кодах с постоянным весом определяется как количество сочетаний из

Рис.2. Примеры разрешенных и запрещенных комбинаций кода МТК-3
К исходной комбинации добавляется такая же комбинация по длине. В линию посылается удвоенное число символов. Если в исходной комбинации четное число единиц, то добавляемая комбинация повторяет исходную комбинацию, если нечетное, то добавляемая комбинация является инверсной по отношению к исходной.
Прием инверсного кода осуществляется в два этапа. На первом этапе суммируются единицы в первой основной группе символов. Если число единиц четное, то контрольные символы принимаются без изменения, если нечетное, то контрольные символы инвертируются. На втором этапе контрольные символы суммируются с информационными символами по модулю два. Нулевая сумма говорит об отсутствии ошибок. При ненулевой сумме, принятая комбинация бракуется. Покажем суммирование для принятых комбинаций без ошибок (1,3) и с ошибками (2,4).
По сравнению с простым кодом, код Грея позволяет уменьшить ошибки неоднозначности считывания, а также ошибки из-за помех в канале. Обычно этот код применяется для аналогово-цифрового преобразования непрерывных сообщений.
Недостатком кода Грея является его невесомость, т.е. вес единицы не определяется номером разряда. Информацию в таком виде трудно обрабатывать на ЭВМ. Декодирование кода также связано с большими затратами. Поэтому перед вводом в ЭВМ (или перед декодированием) код Грея преобразуется в простой двоичный код, который удобен для ЭВМ и легко декодируется.
Для перевода простого двоичного кода в код Грея нужно:
- под двоичным числом записать такое же число со сдвигом вправо на один разряд (при этом младший разряд сдвигаемого числа теряется);
Таким образом, мы рассмотрели виды помехоустойчивого кодирования и увидели, что их существует не так уж и мало. Каждый код по своему уникален и полезен для кодирования информации. Теперь мы ознакомимся с кодом Хемминга подробнее.
Характеристика кода Хэмминга при помехоустойчивом кодировании
В середине 40-х годов Ричард Хемминг работал в знаменитых Лабораториях Белла на счётной машине Bell Model V. Это была электромеханическая машина, использующая релейные блоки,скорость которых была очень низка: один оборот за несколько секунд. Данные вводились в машине с помощью перфокарт, и поэтому в процессе чтения часто происходили ошибки. В рабочие дни использовались специальные коды, чтобы обнаруживать и исправлять найденные ошибки, при этом оператор узнавал об ошибке по свечению лампочек, исправлял и запускал машину. В выходные дни, когда не было операторов, при возникновении ошибки машина автоматически выходила из программы и запускала другую.
К ним обычно относятся коды с минимальным кодовым расстоянием
исправляющие все одиночные ошибки, и коды с расстоянием
исправляющие все одиночные и обнаруживающие все двойные ошибки. Длина кода Хэмминга:
(r – количество проверочных разрядов).
Характерной особенностью проверочной матрицы кода с
является то, что ее столбцы представляют собой любые различные ненулевые комбинации длиной
=5 для кода (15,11), проверочная матрица может иметь следующий вид (рис.3)

Рис.3. Проверочная матрица
Перестановкой столбцов, содержащих одну единицу, данную матрицу можно привести к виду(рис.4)

Рис. 4.Измененная матрица
Использование такого кода позволяет исправить любую одиночную ошибку или обнаружить произвольную ошибку кратности два. Если информационные и проверочные разряды кода нумеровать слева направо, то в соответствии с матрицей получаем систему проверочных уравнений, с помощью которых вычисляем проверочные разряды(рис.5):

Рис.5. Система проверочных уравнений
Двоичный код Хэмминга с кодовым расстоянием
получается путем добавления к коду Хэмминга с
одного проверочного разряда, представляющего собой результат суммирования по модулю два всех разрядов кодового слоя. Длина кода при этом
разрядов, из которых
Таким образом, ознакомившись с характеристикой кода Хемминга, важно сказать, что состоит код из двух частей и предполагает надежную работу нахождения ошибок и корректировки сообщений.